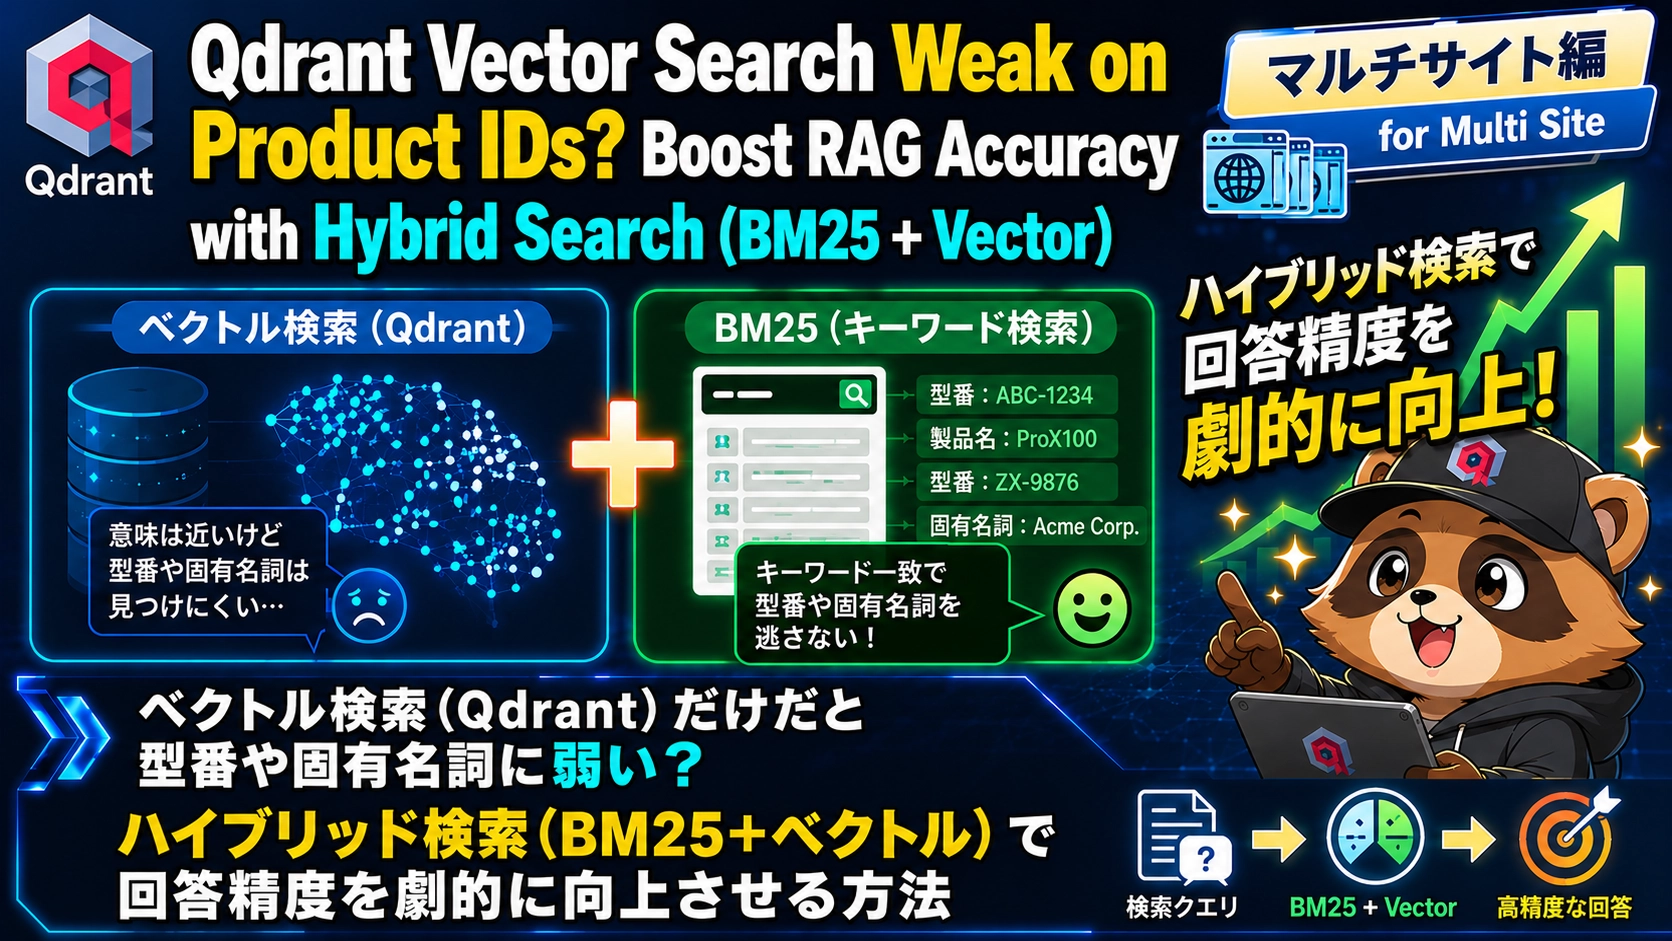
複数のWordPressサイトやブログメディアを運用している際、1台のPython(FastAPI + Qdrant)サーバーに検索基盤を集約しつつも、「ジャンルの異なるサイト同士のデータは完全に隔離したい」という要件はよく発生します。
横断検索のように複数サイトの結果を混ぜてしまうと、全く関係のない別ジャンルの記事がヒットして検索品質が大きく低下してしまいます。
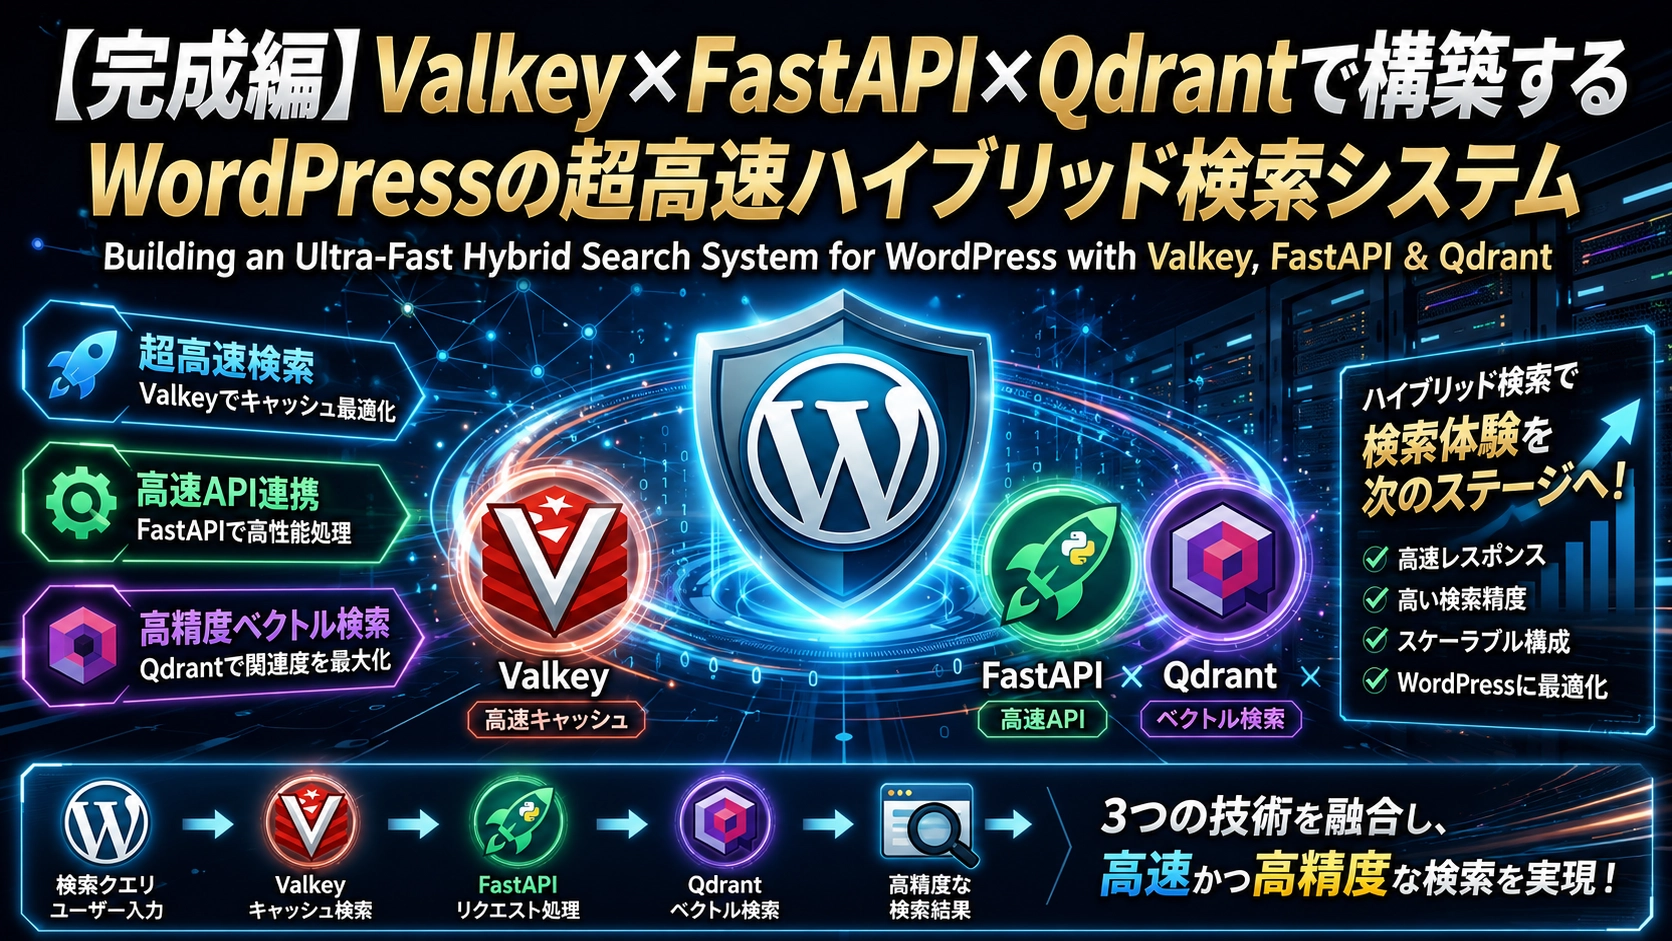
本記事では、Qdrantのコレクション(posts_{site_id})をサイトごとに完全に分離管理することで、単一の検索エンジン基盤を効率的に共有しながら、各サイトのデータが互いに干渉しない独立したハイブリッド検索APIを構築する手順を解説します。
全体構成とディレクトリ構造
1台の検索サーバーで複数サイトのデータを管理するため、Qdrant内では site_id(例: site_a, site_b)ごとにコレクション(posts_site_a, posts_site_b)を独立して作成・管理します。
~/my-search-app/
├── main.py        # Web API サーバー(サイト別独立検索 API)
└── sync_wp.py     # 各WordPress(MySQL) からのデータ同期スクリプト
~/my-search-app/
├── main.py # Web API server (Isolated search API per site)
└── sync_wp.py # Data sync script from each WordPress (MySQL)必要ライブラリのインストール
検索サーバー側で必要なパッケージをインストールします。
# 作業ディレクトリの作成と移動
# Create and move to working directory
mkdir -p ~/my-search-app
cd ~/my-search-app

# 仮想環境の作成と有効化
# Create and activate virtual environment
python3 -m venv venv
source venv/bin/activate

# 必須ライブラリのインストール
# Install required libraries
pip install fastapi uvicorn qdrant-client fastembed rank-bm25 pymysql requests numpy janome tqdmWeb APIサーバーの実装(main.py)
リクエストに含まれる site_id に応じて自動的に対象のコレクション(posts_{site_id})を選択し、他サイトのデータと一切交じり合わないハイブリッド検索処理を実装します。
日本語の形態素解析には Janome を採用しています。
~/my-search-app/main.py を作成します。
import re
from datetime import datetime
from typing import List, Optional
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
import numpy as np
from janome.tokenizer import Tokenizer
from fastembed import TextEmbedding
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, PointStruct, VectorParams
from rank_bm25 import BM25Okapi

app = FastAPI(title="Isolated Multi-site Hybrid Search API with Janome")

# Qdrant永続化ディレクトリ、Embeddingモデル、Janomeの初期化
# Initialize Qdrant persistence directory, embedding model, and Janome tokenizer
client = QdrantClient(path="./qdrant_data")
embedding_model = TextEmbedding(model_name="sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2")
janome_tokenizer = Tokenizer()

# データモデル定義
# Data model definitions
class Article(BaseModel):
    site_id: str
    id: int
    title: str
    content: str
    url: str
    date: str

class SyncPayload(BaseModel):
    articles: List[Article]

class SingleSearchPayload(BaseModel):
    site_id: str
    query: str
    top_k: Optional[int] = 5

# 日本語形態素解析(分かち書き)関数
# Japanese tokenization function using Janome
def tokenize(text: str) -> List[str]:
    # HTMLタグを除去してから形態素解析を実施
    # Remove HTML tags before morphological analysis
    clean_text = re.sub(r'<[^>]+>', ' ', text)
    return list(janome_tokenizer.tokenize(clean_text, wakati=True))

# データ同期API(サイトごとに個別コレクションへインデックス化)
# Data Sync API (Indexing into separate collection per site)
@app.post("/api/sync")
def sync_articles(payload: SyncPayload):
    if not payload.articles:
        return {"status": "ok", "message": "同期データなし / No articles to sync"}

    # リクエスト内の site_id を取得
    # Get site_id from request
    site_id = payload.articles[0].site_id
    collection_name = f"posts_{site_id}"

    # サイト用コレクションが存在しなければ新規作成
    # Create collection for site if it does not exist
    if not client.collection_exists(collection_name=collection_name):
        client.create_collection(
            collection_name=collection_name,
            vectors_config=VectorParams(size=384, distance=Distance.COSINE),
        )

    texts = [f"{a.title} {a.content}" for a in payload.articles]
    embeddings = list(embedding_model.embed(texts))

    points = []
    for article, vector in zip(payload.articles, embeddings):
        points.append(
            PointStruct(
                id=article.id,
                vector=vector.tolist(),
                payload={
                    "title": article.title,
                    "content": article.content,
                    "url": article.url,
                    "date": article.date
                }
            )
        )

    client.upsert(collection_name=collection_name, points=points)
    return {"status": "success", "site_id": site_id, "synced": len(points)}

# サイト別独立検索API
# Isolated Search API for single site
@app.post("/api/search")
def search_single_site(payload: SingleSearchPayload):
    collection_name = f"posts_{payload.site_id}"

    # コレクションの存在確認(未同期サイトからの呼び出し保護)
    # Check if collection exists (Guard against calls from unsynced sites)
    if not client.collection_exists(collection_name=collection_name):
        return {"site_id": payload.site_id, "results": []}

    scroll_res, _ = client.scroll(collection_name=collection_name, limit=10000, with_payload=True, with_vectors=False)
    if not scroll_res:
        return {"site_id": payload.site_id, "results": []}

    docs = [hit.payload for hit in scroll_res]
    doc_ids = [hit.id for hit in scroll_res]

    # --- (A) ベクトル検索 / Vector Search ---
    query_vector = list(embedding_model.embed([payload.query]))[0].tolist()
    vec_res = client.query_points(collection_name=collection_name, query=query_vector, limit=len(docs))
    vec_ranks = {hit.id: rank + 1 for rank, hit in enumerate(vec_res.points)}

    # --- (B) Janomeを使用したBM25キーワード検索 / BM25 Keyword Search using Janome ---
    corpus = [tokenize(f"{d['title']} {d['content']}") for d in docs]
    bm25 = BM25Okapi(corpus)
    tokenized_query = tokenize(payload.query)
    bm25_scores = bm25.get_scores(tokenized_query)
    sorted_bm25_idx = np.argsort(bm25_scores)[::-1]
    bm25_ranks = {doc_ids[idx]: rank + 1 for rank, idx in enumerate(sorted_bm25_idx)}

    # --- (C) RRF スコア算出 + 年号/日付補正 / RRF score calculation with year/date boost ---
    year_match = re.search(r'20\d{2}', payload.query)
    target_year = year_match.group(0) if year_match else None

    results = []
    for doc_id, doc in zip(doc_ids, docs):
        r_vec = vec_ranks.get(doc_id, 999)
        r_bm25 = bm25_ranks.get(doc_id, 999)

        base_score = (1.0 / (60 + r_vec)) + (1.0 / (60 + r_bm25))

        date_boost = 0.0
        if target_year and target_year in doc.get("title", ""):
            date_boost += 0.005
        elif doc.get("date", "").startswith("2024"):
            date_boost += 0.002

        final_score = base_score + date_boost

        results.append({
            "id": doc_id,
            "score": final_score,
            "title": doc.get("title"),
            "url": doc.get("url"),
            "date": doc.get("date")
        })

    sorted_results = sorted(results, key=lambda x: x["score"], reverse=True)[:payload.top_k]
return {"site_id": payload.site_id, "results": sorted_results}プログレスバー付き同期スクリプト(sync_wp.py)
コマンドライン引数で site_id を指定し、該当するWordPressのデータベースからデータを抽出して個別コレクションに格納します。処理の進捗状況(tqdm)を表示しながら同期します。
~/my-search-app/sync_wp.py を作成します。
import sys
import pymysql
import requests
from tqdm import tqdm

# APIエンドポイント設定
# API Endpoint Settings
API_URL = "http://127.0.0.1:8000/api/sync"

# 1回のリクエストで送信する記事数(バッチサイズ)
# Batch size per request
BATCH_SIZE = 50

# サイトごとのDB接続設定定義マップ(環境に合わせて変更してください)
# DB Connection Settings Map for each site (Modify to match your DB environment)
SITE_DB_CONFIGS = {
    "site_a": {
        "host": "localhost",
        "user": "your_db_user_a",      # DBユーザー名 / DB Username
        "password": "your_password_a", # DBパスワード / DB Password
        "database": "wp_site_a_db"     # データベース名 / Database Name
    },
    "site_b": {
        "host": "localhost",
        "user": "your_db_user_b",      # DBユーザー名 / DB Username
        "password": "your_password_b", # DBパスワード / DB Password
        "database": "wp_site_b_db"     # データベース名 / Database Name
    }
}

def get_wp_posts(db_config):
    # 指定DBから公開記事を取得
    # Fetch published posts from specified DB
    connection = pymysql.connect(
        host=db_config["host"],
        user=db_config["user"],
        password=db_config["password"],
        database=db_config["database"],
        charset='utf8mb4',
        cursorclass=pymysql.cursors.DictCursor
    )

    try:
        with connection.cursor() as cursor:
            sql = """
            SELECT ID, post_title, post_content, post_date, guid
            FROM wp_posts
            WHERE post_status = 'publish' AND post_type = 'post'
            """
            cursor.execute(sql)
            return cursor.fetchall()
    finally:
        connection.close()

def main():
    if len(sys.argv) < 2:
        print("Usage: python3 sync_wp.py <site_id>")
        sys.exit(1)

    site_id = sys.argv[1]
    if site_id not in SITE_DB_CONFIGS:
        print(f"Error: Unknown site_id '{site_id}'")
        sys.exit(1)

    db_config = SITE_DB_CONFIGS[site_id]
    posts = get_wp_posts(db_config)
    total_posts = len(posts)

    print(f"[{site_id}] Found {total_posts} articles. Starting synchronization...")

    # プログレスバー(tqdm)を表示しながらバッチ同期処理を実行
    # Execute batch synchronization with progress bar (tqdm)
    with tqdm(total=total_posts, desc=f"Syncing [{site_id}]", unit="posts") as pbar:
        for i in range(0, total_posts, BATCH_SIZE):
            batch_posts = posts[i:i + BATCH_SIZE]

            articles = [
                {
                    "site_id": site_id,
                    "id": p["ID"],
                    "title": p["post_title"],
                    "content": p["post_content"],
                    "url": p["guid"],
                    "date": str(p["post_date"])
                }
                for p in batch_posts
            ]

            payload = {"articles": articles}
            response = requests.post(API_URL, json=payload)

            if response.status_code == 200:
                pbar.update(len(batch_posts))
            else:
                print(f"\nError on batch starting at index {i}: {response.text}")
                break

    print(f"\n[{site_id}] Synchronization completed successfully!")

if __name__ == "__main__":
main()サーバーの起動と各サイトの個別同期実行
Web APIサーバーを起動させ、それぞれのサイトIDを指定して同期スクリプトを実行します。
# 作業ディレクトリと仮想環境の有効化
# Move to directory and activate virtual environment
cd ~/my-search-app
source venv/bin/activate

# nohup でバックグラウンド起動(ログは app.log へ出力)
# Run server in background using nohup (Output logged to app.log)
nohup uvicorn main:app --host 127.0.0.1 --port 8000 > app.log 2>&1 &

# サイトAのデータを「posts_site_a」へ同期
# Sync data for Site A into "posts_site_a"
python3 sync_wp.py site_a

# サイトBのデータを「posts_site_b」へ同期
# Sync data for Site B into "posts_site_b"
python3 sync_wp.py site_b独立検索の動作検証
curl コマンドを使用して、それぞれのサイトが互いのデータに一切影響を与えずに独立して検索結果を返すかテストします。
サイトA(例:PCパーツ系サイト)での検索
# サイトA専用検索テスト
# Search test specifically for site_a
curl -s -X POST "http://127.0.0.1:8000/api/search" \
     -H "Content-Type: application/json" \
-d '{"site_id": "site_a", "query": "グラフィックボード", "top_k": 3}'サイトB(例:料理レシピ系サイト)での検索
# サイトB専用検索テスト
# Search test specifically for site_b
curl -s -X POST "http://127.0.0.1:8000/api/search" \
     -H "Content-Type: application/json" \
-d '{"site_id": "site_b", "query": "カレーレシピ", "top_k": 3}'WordPressテーマ(functions.php)側の呼び出し処理
各WordPressテーマ内からは、自身の site_id を固定パラメータとしてAPIへリクエストを投げます。
/**
 * サイト別独立ハイブリッド検索関数
 * Isolated Multi-site Hybrid Search Function
 */
function fetch_isolated_search_results($query, $site_id, $top_k = 5) {
    $api_url = 'http://127.0.0.1:8000/api/search';

    $payload = array(
        'site_id' => $site_id, // 例: 'site_a' や 'site_b'
        'query'   => $query,
        'top_k'   => $top_k
    );

    $args = array(
        'body'        => json_encode($payload),
        'headers'     => array('Content-Type' => 'application/json'),
        'timeout'     => 5,
        'blocking'    => true,
    );

    $response = wp_remote_post($api_url, $args);

    if (is_wp_error($response)) {
        return array();
    }

    $body = wp_remote_retrieve_body($response);
    $data = json_decode($body, true);

    return isset($data['results']) ? $data['results'] : array();
}検索窓(フロントエンドUI)と検索結果ページの実装
ファイル配置構造
子テーマの直下に custom-search フォルダを作成し、以下の3ファイルで管理します。
/wp-content/themes/[使用中の子テーマ]/
├── functions.php                    # 読み込みコードを1行追加
└── custom-search/
    ├── init.php                      # ショートコード・フック設定
    ├── search-form.php               # 検索窓パーツ(AIインラインアニメーション付き)
└── search-results.php # 検索結果表示パーツ1. functions.php への組み込み
子テーマの functions.php の最下部に以下を追記して、独自検索モジュールを安全に読み込みます。
// custom-search フォルダ内の init.php を確実に読み込む
$custom_search_init = __DIR__ . '/custom-search/init.php';
if (file_exists($custom_search_init)) {
    require_once $custom_search_init;
}2. 初期化・関数定義ファイル(custom-search/init.php)
FastAPI連携、ショートコード化、および検索結果ページのテンプレート切り替えを管理します。
<?php
/**
 * 独自ハイブリッド検索システム 初期化・処理定義
 */

// FastAPI呼び出し用共通関数
function fetch_custom_hybrid_search($query, $site_id = 'site_a', $top_k = 10) {
    if (empty($query)) return array();

    $api_url = 'http://127.0.0.1:8000/api/search';

    $payload = array(
        'site_id' => $site_id,
        'query'   => $query,
        'top_k'   => $top_k
    );

    $args = array(
        'body'        => json_encode($payload),
        'headers'     => array('Content-Type' => 'application/json'),
        'timeout'     => 5,
        'blocking'    => true,
    );

    $response = wp_remote_post($api_url, $args);

    if (is_wp_error($response)) {
        return array();
    }

    $body = wp_remote_retrieve_body($response);
    $data = json_decode($body, true);

    return isset($data['results']) ? $data['results'] : array();
}

// 1. 検索窓呼び出し用ショートコード [custom_search_form] の登録
add_shortcode('custom_search_form', function() {
    ob_start();
    get_template_part('custom-search/search-form');
    return ob_get_clean();
});

// 2. 検索実行時に独自結果パーツを自動適用
add_action('template_redirect', function() {
    if (is_search()) {
        get_header();
        get_template_part('custom-search/search-results');
        get_footer();
        exit;
    }
});3. 検索窓パーツ(custom-search/search-form.php)
AI風のUIと、検索ボタン押下時にフォーム直下で「AI解析中…」とスマートにゲージが走るアニメーションを内包したパーツです。
<?php
/**
 * 独自ハイブリッド検索用 フォームパーツ(AIインラインローディング版)
 */
?>
<div class="qdrant-search-box">
    <form role="search" method="get" class="qdrant-search-form" action="<?php echo esc_url(home_url('/')); ?>" onsubmit="showInlineLoading(this)">
        <div class="input-wrapper">
            <span class="ai-badge">🤖 AI</span>
            <input type="search"
                   class="qdrant-search-input"
                   placeholder="AIに質問・キーワード検索..."
                   value="<?php echo get_search_query(); ?>"
                   name="s"
                   required />
        </div>
        <button type="submit" class="qdrant-search-btn">
            <span class="btn-text">解析検索</span>
        </button>
    </form>

    <!-- 検索ボタン押下時にフォーム直下に出るインラインローディング -->
    <div class="ai-inline-loading" style="display: none;">
        <div class="ai-loading-status">
            <span class="spinner"></span>
            <span>AIがベクトルDB(Qdrant)を解析中...</span>
        </div>
        <div class="ai-progress-bar">
            <div class="ai-progress-line"></div>
        </div>
    </div>
</div>

<style>
.qdrant-search-box {
    width: 100%;
    margin: 15px 0;
    box-sizing: border-box;
}

.qdrant-search-box .qdrant-search-form {
    display: flex;
    align-items: center;
    width: 100%;
    gap: 10px;
    margin: 0;
    padding: 0;
}

.qdrant-search-box .input-wrapper {
    position: relative;
    flex: 1;
    display: flex;
    align-items: center;
}

.qdrant-search-box .ai-badge {
    position: absolute;
    left: 12px;
    font-size: 12px;
    font-weight: bold;
    background: #e0f2fe;
    color: #0369a1;
    padding: 2px 8px;
    border-radius: 4px;
    pointer-events: none;
}

.qdrant-search-box .qdrant-search-input {
    width: 100%;
    height: 46px;
    padding: 0 14px 0 75px;
    border: 1.5px solid #38bdf8;
    border-radius: 8px;
    font-size: 14px;
    background-color: #ffffff;
    color: #0f172a;
    box-sizing: border-box;
    outline: none;
}

.qdrant-search-box .qdrant-search-btn {
    height: 46px;
    padding: 0 20px;
    background: linear-gradient(135deg, #0284c7 0%, #0369a1 100%);
    color: #ffffff;
    font-size: 14px;
    font-weight: bold;
    border: none;
    border-radius: 8px;
    cursor: pointer;
    flex-shrink: 0;
    box-sizing: border-box;
}

/* フォーム直下のローディングUI */
.qdrant-search-box .ai-inline-loading {
    margin-top: 10px;
    padding: 10px 12px;
    background: #f8fafc;
    border: 1px solid #e2e8f0;
    border-radius: 6px;
}

.qdrant-search-box .ai-loading-status {
    display: flex;
    align-items: center;
    gap: 8px;
    font-size: 12px;
    color: #0284c7;
    font-weight: bold;
    margin-bottom: 6px;
}

.qdrant-search-box .spinner {
    display: inline-block;
    width: 14px;
    height: 14px;
    border: 2px solid #bae6fd;
    border-top-color: #0284c7;
    border-radius: 50%;
    animation: qdrant-spin 0.8s linear infinite;
}

.qdrant-search-box .ai-progress-bar {
    width: 100%;
    height: 3px;
    background: #e2e8f0;
    border-radius: 2px;
    overflow: hidden;
    position: relative;
}

.qdrant-search-box .ai-progress-line {
    width: 40%;
    height: 100%;
    background: #0284c7;
    position: absolute;
    left: -40%;
    animation: ai-progress 1.2s infinite ease-in-out;
}

@keyframes qdrant-spin {
    to { transform: rotate(360deg); }
}

@keyframes ai-progress {
    0% { left: -40%; }
    100% { left: 100%; }
}

@media (max-width: 480px) {
    .qdrant-search-box .qdrant-search-form {
        flex-direction: column;
    }
    .qdrant-search-box .input-wrapper,
    .qdrant-search-box .qdrant-search-btn {
        width: 100%;
    }
}
</style>

<script>
function showInlineLoading(form) {
    const box = form.closest('.qdrant-search-box');
    const loading = box.querySelector('.ai-inline-loading');
    if (loading) {
        loading.style.display = 'block';
    }
}
</script>4. 検索結果表示パーツ(custom-search/search-results.php)
FastAPIのハイブリッド検索結果を取得してスコア順に描画する表示パーツです。
<?php
/**
 * 独自ハイブリッド検索用 検索結果表示パーツ
 */
$search_query = get_search_query();

// 自サイトの site_id(例: 'site_a')を指定して FastAPI から検索結果を取得
$site_id = 'site_a'; // ※ ご自身の site_id に書き換えてください
$results = fetch_custom_hybrid_search($search_query, $site_id, 10);
?>

<div class="custom-search-results-wrapper" style="max-width: 800px; margin: 0 auto; padding: 20px;">
    <header class="page-header">
        <h1 class="page-title">
            「<?php echo esc_html($search_query); ?>」の検索結果
        </h1>
    </header>

    <?php if (!empty($results)) : ?>
        <div class="search-results-list" style="margin-top: 20px;">
            <?php foreach ($results as $item) : ?>
                <article class="search-result-item" style="margin-bottom: 24px; padding-bottom: 16px; border-bottom: 1px solid #eee;">
                    <h2 style="font-size: 18px; margin-bottom: 8px;">
                        <a href="<?php echo esc_url($item['url']); ?>" style="color: #0073aa; text-decoration: none;">
                            <?php echo esc_html($item['title']); ?>
                        </a>
                    </h2>
                    <div class="meta-info" style="font-size: 12px; color: #888;">
                        <span>投稿日: <?php echo esc_html($item['date']); ?></span> |
                        <span>適合度スコア: <?php echo esc_html(number_format($item['score'], 4)); ?></span>
                    </div>
                </article>
            <?php endforeach; ?>
        </div>
    <?php else : ?>
        <p style="margin-top: 20px;">該当する記事は見つかりませんでした。</p>
    <?php endif; ?>
</div>5. 検索窓の呼び出し
記事本文やウィジェット、カスタムHTMLブロックなど、表示したい場所でショートコードを記述します。
[custom_search_form]まとめ
本構成により、1台の検索サーバーリソース(Python / FastAPI / Qdrant)を無駄なく共有しながらも、ジャンルや目的が全く異なるサイト同士のデータを物理的に分離することが可能になりました。
- データ混同の防止: コレクションレベルで完全に分離されるため、全く異なるジャンルの記事がノイズとして検索結果に混ざるリスクがゼロになります。
- サーバー運用の効率化: サイトごとに別々の検索サーバーを立てる必要がなく、インフラ費用や保守の手間を削減できます。
- 個別チューニングの容易さ: 必要に応じてサイトごとにRRFの重みやブースト条件を変更したい場合も、
site_idごとに分岐処理を容易に追加可能です。
ジャンルの異なる複数サイトをスマートに1台のサーバーで管理したい場合の設計パターンとして、ぜひご活用ください。
コメント