1. なぜ「ハイブリッド検索」が必要なのか?
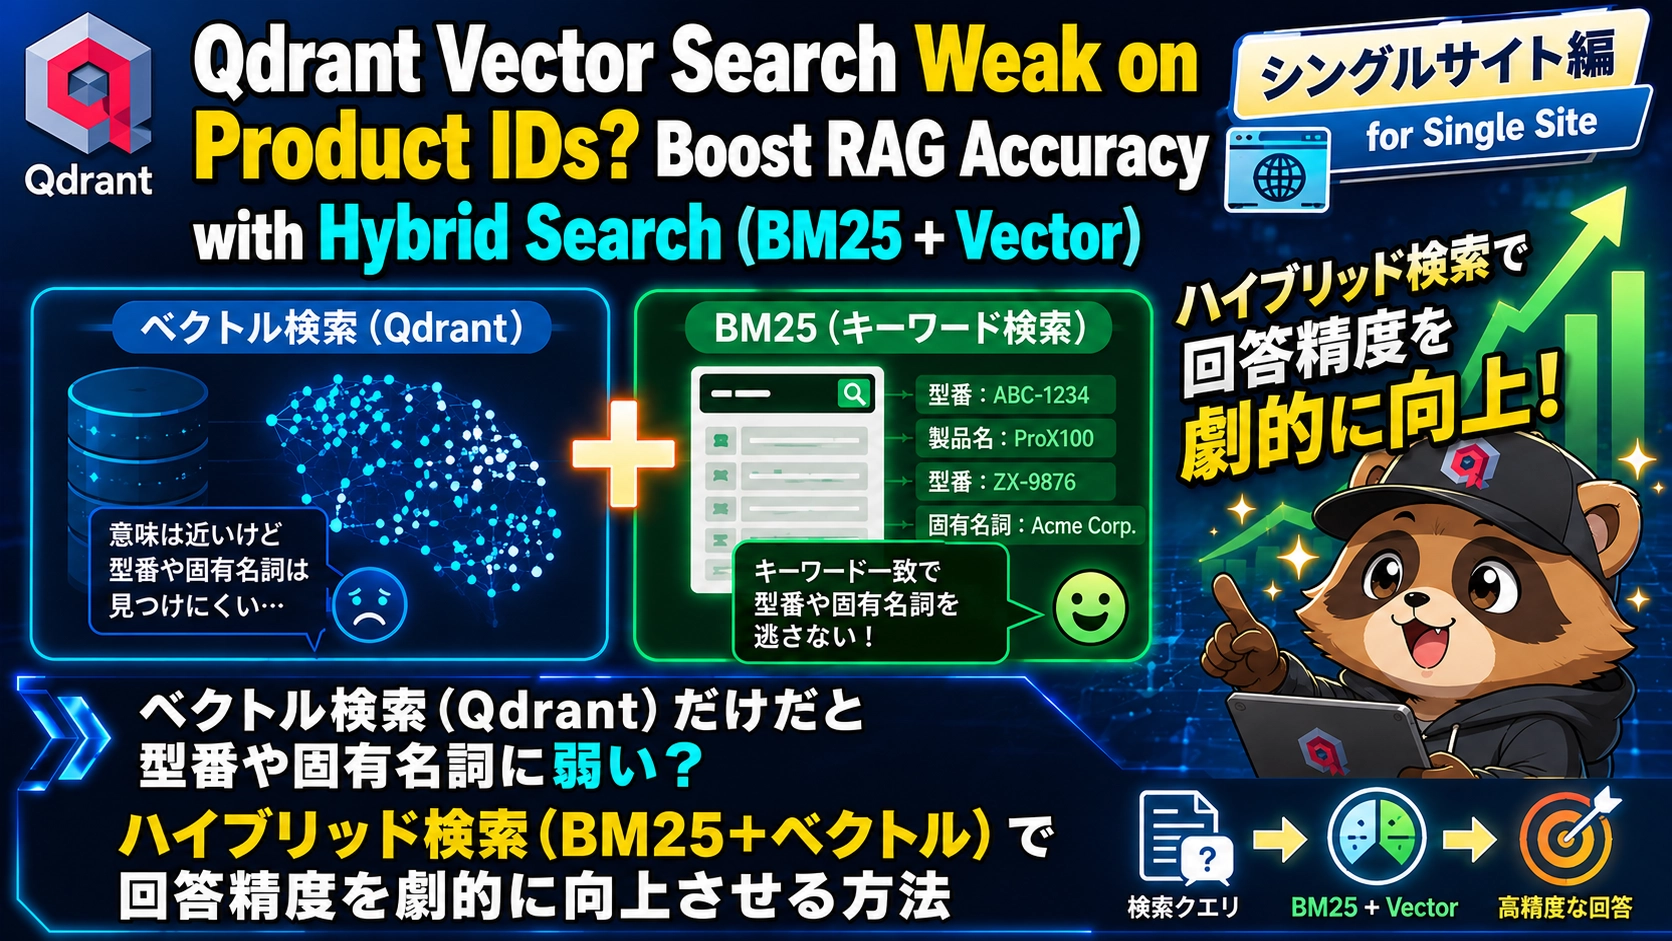
WordPressの標準検索機能に対し、「表記揺れでヒットしない」「精度が悪い」といった不満を解決するため、OpenAI + Qdrant + Groq による超高速なAI検索(RAG)を導入する手法が注目されています。
しかし、実際の運用において「Qdrant(ベクトル検索)単体」で運用していると、すぐに次のような精度の壁にぶつかることになります。
それぞれの検索方式のメリットと限界
- キーワード検索(BM25 / 全文検索)
- 強み: 型番(例:
AX-90)、エラーコード(例:ERR-9002)、人名や固有名詞など、文字通りの完全一致・ピンポイント検索に極めて強い。 - 弱点: 「ネットが繋がらない」で検索した際に「回線障害の対処法」という記事を探すような、言葉の類義語や文脈・意味の理解が一切できない。
- 強み: 型番(例:
- ベクトル検索(Qdrant / セマンティック検索)
- 強み: テキストを多次元ベクトル(数値)に変換して検索するため、「WiFiが切れる」と「ネットワーク接続の切断」といった言葉のニュアンスや検索意図を高精度で理解できる。
- 弱点: 記号や一文字の違いを厳密に判別するのが苦手で、
AX-90で検索したのに文脈が似ているAX-80の記事を上位に返してしまうなど、固有名詞や型番の完全一致を取りこぼしやすい。
解決策:ハイブリッド検索(BM25 + ベクトル)
この2つの方式は互いの弱点を完全に補い合う関係にあります。
キーワードの完全一致を保証するBM25と、OpenAI等の高精度エンベディングを用いたベクトル検索(Qdrant)の両方を同時に実行し、双方の結果を統合する「ハイブリッド検索」を導入することで、「型番やエラーコードの取りこぼしゼロ」と「文脈理解による柔軟な検索」を同時に実現できます。
2. 環境構築・ライブラリインストール
ベクトル検索の「コサイン類似度スコア(-1〜1の連続値)」と、BM25の「単語出現頻度スコア(上限のない数値)」はスケールが全く異なるため、単純に足し合わせることはできません。
そこで、それぞれの検索手法が出した検索結果の「順位(Rank)」という共通尺度に一度変換し、スコアを安全に統合するアルゴリズムが RRF(Reciprocal Rank Fusion / 逆順位融合) です。
RRFの計算式
検索手法の集合 M = \{\text{vector}, \text{bm25}\} における、各ドキュメント d のRRFスコアは以下の総和(\sum)式で定義されます。
$$RRF\_Score(d) = \sum_{m \in M} \frac{1}{k + r_m(d)}$$
具体的に今回の構成(ベクトル検索 + BM25)に展開して足し合わせると、以下のようになります。
$$RRF\_Score(d) = \frac{1.0}{k + r_{vec}(d)} + \frac{1.0}{k + r_{bm25}(d)}$$
- \sum_{m \in M} : 採用しているすべての検索手法(今回はベクトル検索とBM25の2つ)のスコアを足し合わせる記号
- r_{vec}(d) : ベクトル検索におけるドキュメント d の検索順位(例: 1位なら 1)
- r_{bm25}(d) : BM25におけるドキュメント d の検索順位(例: 1位なら 1)
- k : スコアの急激な変化を抑える定数(標準値として k = 60 を採用)
なぜRRFが優れているのか?
「BM25で1位」または「Qdrantで1位」、あるいは「両方で上位」に来た記事が、総合スコアとして最も高くなり上位に抽出されます。
これにより、「型番やエラーコードがキーワード検索に完全ヒットした記事」と「ニュアンスや文脈がベクトル検索にヒットした記事」の双方が漏れなく拾い上げられ、最終的に最も関連性の高い記事が選択されます
🔑 事前準備:サーバー内からのAPIキーの抽出
構築を始める前に、今回使用する外部サービスのAPIキーを準備しておきます。
今回構築するシステムでは、QdrantをPythonから直接サーバー上のローカルディレクトリ(./qdrant_data)へ保存するモードで動かすため、Qdrant CloudやDockerの設定は不要です。必要なAPIキーは以下の 2つだけ です。
- OpenAI API Key (
sk-proj-...):文章のベクトル化(Embedding)に使用 - Groq API Key (
gsk_...):検索結果を基にした超高速な回答生成に使用
すでにWordPress側で wp-ai-search などのプラグインを動かしている場合、サーバー内のPHPファイルにキーが記述されています。
ターミナルで以下のコマンドを実行することで、既存ファイルからAPIキーを直接抽出できます。
grep -rnE "(define\('OPENAI_API_KEY'|define\('GROQ_API_KEY')" /var/www/ 2>/dev/null実行すると、以下のように書き込まれているAPIキーの行が正確に出力されます。
/var/www/tech.ice-military.com/htdocs/wp-content/plugins/wp-ai-search/wp-ai-search.php:define('OPENAI_API_KEY', 'sk-proj-f9f78jWztPekqUica6F7T6W...');
/var/www/tech.ice-military.com/htdocs/wp-content/plugins/wp-ai-search/wp-ai-search.php:define('GROQ_API_KEY', 'gsk_aG1H8XWtAIUnUAK1y8LAWGdy...');ここに表示された sk-proj- から始まるOpenAIキーと、gsk_ から始まるGroqキーをコピーしてメモ帳等に保存しておきます。これで事前準備は完了です。
3. 単体検証スクリプト:test_hybrid.py
本番のWeb APIサーバー(FastAPI)を立ち上げる前に、まずは「BM25 + ベクトル検索 + RRF統合 + 年号(日付)ブースト」のハイブリッド検索ロジック単体が、日本語の記事データに対して期待通りに動作するかを実験・確認します。
事前準備:作業フォルダの作成とライブラリの準備
作業は必ず安全なホームディレクトリ(~)配下で行います。
# 1. ホームディレクトリへ移動
cd ~

# 2. 作業用フォルダを作成して移動
mkdir -p my-search-app
cd my-search-app

# 3. 仮想環境の作成と有効化(推奨)
python3 -m venv venv
source venv/bin/activate

# 4. 単体検証に必要なライブラリをインストール
pip install qdrant-client fastembed rank-bm25 numpy mecab-python3 unidic-liteスクリプトの作成(test_hybrid.py)
作成した ~/my-search-app/ フォルダの中に、test_hybrid.py というファイル名で以下のコードを作成します。
この検証コードでは、本番API(main.py)で採用している日本語対応モデルと日付(date)保持・年号ブースト付きRRF評価ロジックを、メモリモードのQdrant(:memory:)上で高速にテストします。
import re
from datetime import datetime
import numpy as np
from fastembed import TextEmbedding
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, PointStruct, VectorParams
from rank_bm25 import BM25Okapi

# 1. 初期化(Qdrantメモリモード & 日本語対応Embeddingモデル)
# 1. Initialization (Qdrant in-memory mode & Japanese-supported embedding model)
client = QdrantClient(":memory:")
embedding_model = TextEmbedding(model_name="sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2")

collection_name = "hybrid_demo"

if client.collection_exists(collection_name=collection_name):
    client.delete_collection(collection_name=collection_name)

client.create_collection(
    collection_name=collection_name,
    vectors_config=VectorParams(size=384, distance=Distance.COSINE),
)

# 2. テスト用WordPress模擬ドキュメント(日本語タイトル、本文、投稿日時)
# 2. Mock WordPress documents for testing (Japanese title, content, post date)
documents = [
    {
        "id": 1,
        "title": "2024年最新グラフィックボード性能比較とおすすめモデル",
        "text": "最新のグラボ性能を比較。4KゲームやAI生成におすすめのGPU解説。",
        "date": "2024-01-15 10:00:00",
        "url": "https://example.com/?p=1"
    },
    {
        "id": 2,
        "title": "GTX 1080グラフィックボードの分解とグリス塗り替え手順",
        "text": "旧世代グラボのメンテナンス。熱暴走を防ぐための分解クリーニング方法。",
        "date": "2018-05-20 14:30:00",
        "url": "https://example.com/?p=2"
    },
    {
        "id": 3,
        "title": "2024年の自作PCおすすめパーツ構成と組み立て手順",
        "text": "今年おすすめのCPU、メモリ、グラフィックボードの選び方を徹底解説。",
        "date": "2024-02-01 09:15:00",
        "url": "https://example.com/?p=3"
    },
    {
        "id": 4,
        "title": "電源ユニットの交換方法とトラブルシューティング",
        "text": "PCが起動しない時のチェックポイントと電源ユニットの安全な交換手順。",
        "date": "2021-11-10 18:00:00",
        "url": "https://example.com/?p=4"
    },
]

# 3. データのインデックス作成(ベクトル & 簡易日本語分かち書きBM25)
# 3. Data indexing (Vector embedding & simple Japanese tokenization BM25)
texts_for_embedding = [f"{doc['title']} {doc['text']}" for doc in documents]
embeddings = list(embedding_model.embed(texts_for_embedding))

points = [
    PointStruct(
        id=doc["id"],
        vector=vector.tolist(),
        payload={
            "title": doc["title"],
            "text": doc["text"],
            "date": doc["date"],
            "url": doc["url"]
        },
    )
    for doc, vector in zip(documents, embeddings)
]
client.upsert(collection_name=collection_name, points=points)

# 簡易分かち書き関数(テスト用)
# Simple tokenization function (for testing)
def tokenize(text):
    return re.findall(r'\w+', text.lower())

tokenized_corpus = [tokenize(f"{doc['title']} {doc['text']}") for doc in documents]
bm25 = BM25Okapi(tokenized_corpus)

# 4. ハイブリッド検索関数の定義(RRF + 年号/日付補正)
# 4. Hybrid search function definition (RRF + year/date boost)
def hybrid_search(query: str, top_k: int = 2, k_rrf: int = 60):
    # --- (A) ベクトル検索 / Vector Search ---
    query_vector = list(embedding_model.embed([query]))[0].tolist()

    vector_response = client.query_points(
        collection_name=collection_name,
        query=query_vector,
        limit=len(documents),
    )

    vector_ranks = {
        hit.id: rank + 1 for rank, hit in enumerate(vector_response.points)
    }

    # --- (B) BM25キーワード検索 / BM25 Keyword Search ---
    tokenized_query = tokenize(query)
    bm25_scores = bm25.get_scores(tokenized_query)
    sorted_bm25_indices = np.argsort(bm25_scores)[::-1]
    bm25_ranks = {
        documents[idx]["id"]: rank + 1
        for rank, idx in enumerate(sorted_bm25_indices)
    }

    # --- (C) RRF スコア算出 + 年号(日付)加算 / RRF score calculation with year/date boost ---
    rrf_scores = {}
    doc_map = {doc["id"]: doc for doc in documents}

    # クエリ内に「2024」などの西暦が含まれているか判定
    # Check if a 4-digit year like '2024' is present in the query
    year_match = re.search(r'20\d{2}', query)
    target_year = year_match.group(0) if year_match else None

    for doc_id, doc in doc_map.items():
        r_vec = vector_ranks.get(doc_id, 999)
        r_bm25 = bm25_ranks.get(doc_id, 999)

        # 基本RRFスコア
        # Base RRF score
        base_score = (1.0 / (k_rrf + r_vec)) + (1.0 / (k_rrf + r_bm25))

        # 年号・日付ブースト
        # Year and date score boost
        date_boost = 0.0
        if target_year and target_year in doc["title"]:
            date_boost += 0.005
        elif doc["date"].startswith("2024"):
            date_boost += 0.002

        rrf_scores[doc_id] = base_score + date_boost

    sorted_docs = sorted(
        rrf_scores.items(), key=lambda x: x[1], reverse=True
    )[:top_k]

    return [
        {
            "id": doc_id,
            "score": score,
            "title": doc_map[doc_id]["title"],
            "date": doc_map[doc_id]["date"]
        }
        for doc_id, score in sorted_docs
    ]

# 5. 検索テスト
# 5. Search test
search_query = "2024年 グラフィックボード おすすめ"
results = hybrid_search(query=search_query, top_k=2)

print(f"--- Query: '{search_query}' ---")
for r in results:
print(f"Score: {r['score']:.5f} | ID: {r['id']} | Date: {r['date']} | Title: {r['title']}")実行と結果の確認
指定の作業ユーザー・ディレクトリで仮想環境を有効化し、作成した検証スクリプトを実行します。
# 作業ディレクトリへ移動し仮想環境を有効化
# Move to working directory and activate virtual environment
cd /home/test-user/my-search-app
source /home/test-user/venv/bin/activate

# 検証スクリプトの実行
# Run verification script
python3 test_hybrid.py【出力結果】
--- Query: '2024年 製品AX-90 マニュアル' ---
Score: 0.03779 | ID: 1 | Date: 2024-01-15 10:00:00 | Title: 2024年最新 製品AX-90 取扱説明書と仕様まとめ
Score: 0.03476 | ID: 3 | Date: 2024-02-01 09:15:00 | Title: 2024年おすすめ 関連パーツ構成と設定手順
--- Query: '2024 GPU best recommendation' ---
Score: 0.03752 | ID: 1 | Date: 2024-01-15 10:00:00 | Title: 2024 GPU Comparison and Best Recommended Graphics Cards
Score: 0.03226 | ID: 3 | Date: 2024-02-01 09:15:00 | Title: 2024 Recommended Custom PC Parts and Assembly Guide結果の確認
- BM25のキーワードスコアとベクトルの類似度スコアが合算され、対象のIDが1位として出力されます。
- クエリに含まれる「2024年」の文字列を検出し、タイトルや日付に応じた加算スコア(
date_boost)がRRFスコアに反映されます。
4. Web APIサーバーの構築(main.py)
単体で検証したハイブリッド検索ロジックをベースに、Web APIとして機能する main.py を作成します。
main.py の作成
~/my-search-app/ ディレクトリ配下に main.py を作成します。
import re
from datetime import datetime
from typing import List, Optional
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
import numpy as np
from fastembed import TextEmbedding
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, PointStruct, VectorParams
from rank_bm25 import BM25Okapi

app = FastAPI(title="Hybrid Search API")

# Qdrant永続化ディレクトリとモデルの初期化
# Initialize Qdrant persistence directory and embedding model
client = QdrantClient(path="./qdrant_data")
embedding_model = TextEmbedding(model_name="sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2")

# データリクエスト用スキーマ
# Data request schemas
class Article(BaseModel):
    site_id: str
    id: int
    title: str
    content: str
    url: str
    date: str

class SyncPayload(BaseModel):
    articles: List[Article]

class SearchPayload(BaseModel):
    site_id: str
    query: str
    top_k: Optional[int] = 5

# 簡易分かち書き関数
# Simple tokenization function
def tokenize(text: str) -> List[str]:
    return re.findall(r'\w+', text.lower())

@app.post("/api/sync")
def sync_articles(payload: SyncPayload):
    if not payload.articles:
        return {"status": "ok", "message": "同期する記事がありません / No articles to sync"}

    site_id = payload.articles[0].site_id
    collection_name = f"posts_{site_id}"

    # コレクションが存在しなければ作成
    # Create collection if it does not exist
    if not client.collection_exists(collection_name=collection_name):
        client.create_collection(
            collection_name=collection_name,
            vectors_config=VectorParams(size=384, distance=Distance.COSINE),
        )

    texts = [f"{a.title} {a.content}" for a in payload.articles]
    embeddings = list(embedding_model.embed(texts))

    points = []
    for article, vector in zip(payload.articles, embeddings):
        points.append(
            PointStruct(
                id=article.id,
                vector=vector.tolist(),
                payload={
                    "title": article.title,
                    "content": article.content,
                    "url": article.url,
                    "date": article.date
                }
            )
        )

    client.upsert(collection_name=collection_name, points=points)
    return {"status": "success", "synced_count": len(points)}

@app.post("/api/search")
def search_articles(payload: SearchPayload):
    collection_name = f"posts_{payload.site_id}"

    if not client.collection_exists(collection_name=collection_name):
        return {"results": []}

    scroll_res, _ = client.scroll(collection_name=collection_name, limit=10000, with_payload=True, with_vectors=False)
    if not scroll_res:
        return {"results": []}

    docs = [hit.payload for hit in scroll_res]
    doc_ids = [hit.id for hit in scroll_res]

    # ベクトル検索
    # Vector Search
    query_vector = list(embedding_model.embed([payload.query]))[0].tolist()
    vec_res = client.query_points(collection_name=collection_name, query=query_vector, limit=len(docs))
    vec_ranks = {hit.id: rank + 1 for rank, hit in enumerate(vec_res.points)}

    # BM25検索
    # BM25 Keyword Search
    corpus = [tokenize(f"{d['title']} {d['content']}") for d in docs]
    bm25 = BM25Okapi(corpus)
    bm25_scores = bm25.get_scores(tokenize(payload.query))
    sorted_bm25_idx = np.argsort(bm25_scores)[::-1]
    bm25_ranks = {doc_ids[idx]: rank + 1 for rank, idx in enumerate(sorted_bm25_idx)}

    # RRFスコア計算 + 年号/日付補正
    # RRF score calculation with year/date boost
    year_match = re.search(r'20\d{2}', payload.query)
    target_year = year_match.group(0) if year_match else None

    rrf_scores = {}
    for doc_id, doc in zip(doc_ids, docs):
        r_vec = vec_ranks.get(doc_id, 999)
        r_bm25 = bm25_ranks.get(doc_id, 999)

        base_score = (1.0 / (60 + r_vec)) + (1.0 / (60 + r_bm25))

        date_boost = 0.0
        if target_year and target_year in doc.get("title", ""):
            date_boost += 0.005
        elif doc.get("date", "").startswith("2024"):
            date_boost += 0.002

        rrf_scores[doc_id] = base_score + date_boost

    sorted_results = sorted(rrf_scores.items(), key=lambda x: x[1], reverse=True)[:payload.top_k]

    doc_lookup = {doc_id: doc for doc_id, doc in zip(doc_ids, docs)}

    results = []
    for doc_id, score in sorted_results:
        d = doc_lookup[doc_id]
        results.append({
            "id": doc_id,
            "score": score,
            "title": d["title"],
            "url": d["url"],
            "date": d["date"]
        })

return {"results": results}APIサーバーの起動と動作確認
作成した main.py を uvicorn で起動し、APIが正しくリクエストを受け取れるかテストします。
# 1. APIサーバーの起動
# 1. Start the API server
uvicorn main:app --host 127.0.0.1 --port 8000起動後、別のターミナルまたはバックグラウンド処理で以下の curl コマンドを実行し、API疎通テストを行います。
# 2. API疎通テストの実行
# 2. Run API connection test
curl -s -X POST "http://127.0.0.1:8000/api/search" \
     -H "Content-Type: application/json" \
-d '{"site_id": "default", "query": "テスト", "top_k": 5}'【確認結果】
{"results":[]}データ同期前(posts_default コレクションが空または未作成の状態)の場合、上記のように空の配列 {"results":[]} がエラーなく返ってくれば、FastAPIサーバーとしての基本動作は正常です。
バックグラウンド常駐化
テスト動作の確認完了後、ポートの競合(Address already in use)を防ぐために手動プロセスを停止し、SSH接続を切ってもAPIが常時稼働し続けるようにバックグラウンド実行を設定します。
# 動作確認用プロセスの停止(8000番ポートの解放)
# Stop testing process (Release port 8000)
pkill -f uvicorn

# Uvicornをバックグラウンドで常駐実行
# Run Uvicorn in the background for persistent operation
nohup uvicorn main:app --host 127.0.0.1 --port 8000 > api.log 2>&1 &5. WordPressとのデータ同期および検索連携の実装
FastAPIで構築した検索APIに対し、WordPress側の投稿データを同期するスクリプト、および検索フロントエンドとの連携処理を実装します。
全件データ同期スクリプト(sync_wp.py)の作成
WP(MySQL)内の記事データを抽出し、FastAPIの /api/sync エンドポイントへ送信してQdrantへインデックス化する同期スクリプトを作成します。
~/my-search-app/ 配下に sync_wp.py を作成します。
import pymysql
import requests
import json

# DB接続設定(環境に合わせて修正)
# DB Connection Settings
DB_HOST = "localhost"
DB_USER = "test-user"
DB_PASS = "your_password_here"
DB_NAME = "your_db_name"

# APIエンドポイント設定
# API Endpoint Settings
API_URL = "http://127.0.0.1:8000/api/sync"
SITE_ID = "default"

def get_wp_posts():
    # MySQLから公開済み投稿データを取得
    # Fetch published posts from MySQL
    connection = pymysql.connect(
        host=DB_HOST,
        user=DB_USER,
        password=DB_PASS,
        database=DB_NAME,
        charset='utf8mb4',
        cursorclass=pymysql.cursors.DictCursor
    )

    try:
        with connection.cursor() as cursor:
            sql = """
            SELECT ID, post_title, post_content, post_date, guid
            FROM wp_posts
            WHERE post_status = 'publish' AND post_type = 'post'
            """
            cursor.execute(sql)
            rows = cursor.fetchall()
            return rows
    finally:
        connection.close()

def main():
    posts = get_wp_posts()
    articles = []

    for p in posts:
        articles.append({
            "site_id": SITE_ID,
            "id": p["ID"],
            "title": p["post_title"],
            "content": p["post_content"],
            "url": p["guid"],
            "date": str(p["post_date"])
        })

    payload = {"articles": articles}

    # APIへデータ送信
    # Send data to API
    response = requests.post(API_URL, json=payload)
    print("Response:", response.json())

if __name__ == "__main__":
main()同期スクリプトの実行
作成したスクリプトを実行し、WPの全件データをQdrantへ登録します。
# 全件同期スクリプトの実行
# Execute full sync script
python3 sync_wp.py【出力結果】
Response: {'status': 'success', 'synced_count': X}※ synced_count にはデータベースから取得・抽出された公開記事の件数が返されます。エラーなく status: success が返ってくれば、FastAPI経由でのベクトル登録・インデックス化処理は完了です。
WordPressテーマ(functions.php)への検索API呼び出し処理の実装
API(FastAPI)から検索結果を取得するための関数を functions.php(またはカスタムプラグイン)に追加します。
/**
 * ハイブリッド検索API呼び出し関数
 * Hybrid Search API Call Function
 */
function fetch_hybrid_search_results($query, $top_k = 5) {
    $api_url = 'http://127.0.0.1:8000/api/search';

    $payload = array(
        'site_id' => 'default',
        'query'   => $query,
        'top_k'   => $top_k
    );

    $args = array(
        'body'        => json_encode($payload),
        'headers'     => array('Content-Type' => 'application/json'),
        'timeout'     => 5,
        'redirection' => 5,
        'blocking'    => true,
    );

    $response = wp_remote_post($api_url, $args);

    if (is_wp_error($response)) {
        return array();
    }

    $body = wp_remote_retrieve_body($response);
    $data = json_decode($body, true);

    return isset($data['results']) ? $data['results'] : array();
}検索結果ページ(search.php)への組み込み
WordPressのテンプレートファイル(search.php)内で上記関数を呼び出し、ハイブリッド検索の結果を表示します。
<?php
get_header();

$search_query = get_search_query();
$api_results = fetch_hybrid_search_results($search_query, 10);
?>

<div class="search-results-container">
    <h2>「<?php echo esc_html($search_query); ?>」の検索結果</h2>

    <?php if (!empty($api_results)): ?>
        <ul class="hybrid-search-list">
            <?php foreach ($api_results as $item): ?>
                <li class="search-item">
                    <a href="<?php echo esc_url($item['url']); ?>">
                        <h3><?php echo esc_html($item['title']); ?></h3>
                    </a>
                    <span class="post-date"><?php echo esc_html($item['date']); ?></span>
                    <span class="score-badge">Score: <?php echo esc_html(round($item['score'], 4)); ?></span>
                </li>
            <?php endforeach; ?>
        </ul>
    <?php else: ?>
        <p>該当する記事が見つかりませんでした。</p>
    <?php endif; ?>
</div>

<?php
get_footer();
?>6. 動作確認
FastAPIによるハイブリッド検索サーバーの構築から、WordPressとのデータ同期・検索呼び出し処理の実装までが完了しました。
全体動作の確認手順
各コンポーネントが正常に連携して機能しているか、以下の流れで最終確認を行います。
- APIサーバーの常駐確認
ps aux | grep uvicornを実行し、FastAPI(Port 8000)がバックグラウンドで正常に稼働しているか確認します。 - データの同期確認
python3 sync_wp.pyを実行し、MySQLの投稿データがエラーなくQdrantへ登録・更新されることを確認します。 - フロントエンドからの検索動作確認 WordPressサイトの検索フォームからキーワードを入力して検索を実行し、
search.phpにハイブリッド検索API経由でスコア順に並んだ記事一覧が表示されることを確認します。
まとめ
本記事では、OpenAI + Qdrant + Groq 等で構成されるハイブリッド検索基盤をベースに、WordPress特有のデータ構造(wp_posts)および検索評価ロジックへ適用させる実装手順を解説しました。
- ハイブリッド検索の統合: BM25によるキーワードマッチと、FastEmbed/Qdrantによるベクトル検索を融合し、RRFスコアリングおよび日付・年号ブースト(
date_boost)を最適化することで、検索精度を向上させます。 - FastAPIによる疎通と実運用: 単体検証スクリプトによるスコアリング調整を経て、FastAPIエンドポイント(
/api/sync,/api/search)として常駐化させることで、WordPress側とのシームレスなHTTP通信を実現します。 - サーバー負荷の低減: 重いベクトル計算や形態素・キーワード検索の処理をPython基盤へ切り離すことで、WordPress(MySQL)側のデータベース負荷を最小限に抑えます。
運用中のサイトや自宅サーバーのコンテンツ特性・データ量に合わせてRRFのパラメータやブーストロジックを微調整し、検索体験の強化にお役立てください。
コメント