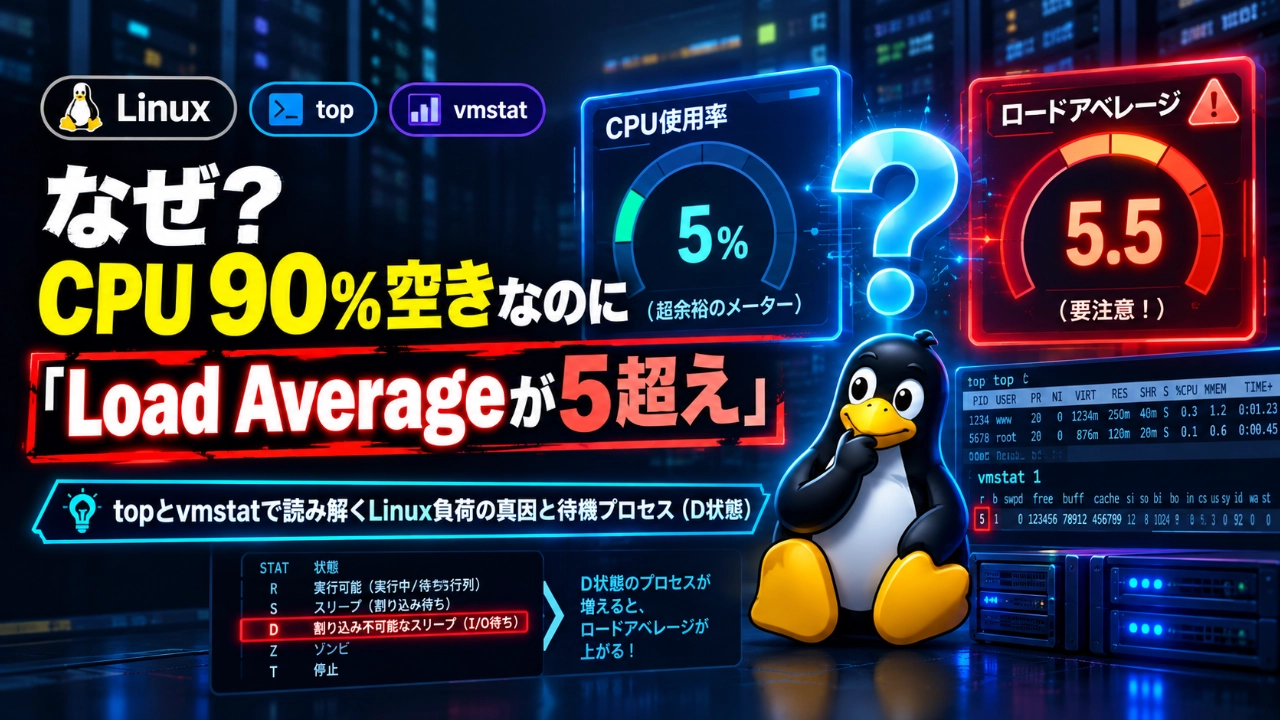
Linuxサーバーの監視ツールやアラートで「ロードアベレージ高騰」の通知を受け、慌ててSSHでログインして top コマンドを叩いたところ、以下のような奇妙な出力に遭遇した経験はないでしょうか。
top - 03:05:29 up 18 days,  load average: 5.54, 4.60, 2.40
Tasks: 741 total,   2 running, 739 sleeping,   0 stopped,   0 zombie
%Cpu(s): 1.8 us, 2.7 sy, 0.0 ni, 94.6 id, 0.9 wa, 0.0 hi, 0.0 si, 0.0 stload average は 5.54 と高めの数値を指しているにもかかわらず、CPUアイドル率(%id)を見ると 94.6% も余っており、CPU使用率は実質5%程度しか使われていません。
「CPUが余っているのに、なぜロードアベレージだけが異常に高いのか?」
本記事では、この矛盾が生じるLinuxカーネルの仕組みと、vmstat を併用して真のボトルネックを特定する調査手法を解説します。
1. そもそも「ロードアベレージ」の正体とは?
多くの人が「ロードアベレージ = CPUの忙しさ」と誤解しがちですが、Linuxにおけるロードアベレージの定義は少し異なります。
ロードアベレージとは、「CPUの処理を待っているプロセス」+「ディスクなどのI/O完了を待っているプロセス」の平均数(直近1分、5分、15分)です。
プロセス状態(Process State)で表現すると、以下の2つの合計値です。
- R状態(Running / Runnable):CPUコア上で現行実行されている、またはCPUの空きを順番待ちしているプロセス。
- D状態(Uninterruptible Sleep / 割り込み不可の待機状態):主にディスクの読み書き(I/O)待ちなどで、ハードウェアの応答を一時停止して待っているプロセス。
つまり、CPUコアがどれだけ空いていようと、ストレージの応答待ち(D状態)のプロセスが複数溜まっていれば、ロードアベレージは簡単に5でも10でも跳ね上がります。
2. CPUが空いているのに負荷が高くなる主なシナリオ
今回のケースのように「CPU 90%以上アイドル+ロードアベレージ高騰」が発生する典型的なシナリオは以下の2つです。
パターンA:大量ファイル操作によるディスクI/O詰まり
数万枚単位の画像整理、バックアップのアーカイブ生成、データベースの巨大ダンプ取得などを走らせると、ストレージの転送帯域が上限に達します。
このとき、ファイルアクセスを試みたプロセス群が一斉に「D状態」でスタックし、CPU使用率とは無関係にロードアベレージが急上昇します。
パターンB:サーバー起動直後のデーモン一斉初期化
OS再起動(リブート)の直後は、以下のような重厚なバックグラウンドサービスが一斉に立ち上がります。
- 監視エージェント(Prometheusのデータ初期ロード、Netdataのメトリクス収集)
- Webスタック(Nginxの起動、PHP-FPMの複数ワーカープール立ち上げ、MariaDBのバッファ確保)
- セキュリティ関連(fail2ban、mta-stsなど)
これらのサービスが同時にディスク設定ファイルの読み込みやソケットバインドを要求するため、起動後数分間は待機キューが一時的に膨らみ、ロードアベレージが急上昇します。
3. 実践:vmstat で真の原因を切り分ける
top だけでは「CPU使用率」と「ロードアベレージの数値」しか見えないため、vmstat(Virtual Memory Statistics) を組み合わせて原因を特定します。
ターミナルで以下のコマンドを実行します(1秒間隔で5回サンプリング)。
vmstat 1 5出力結果の例:
procs -----------memory---------- ---swap-- -----io---- -system-- -------cpu-------
 r  b   swpd   free   buff  cache   si   so    bi    bo   in    cs us sy id wa st gu
 1  0      0 39327748 133000 3583068    0    0  7973  3082 6133   18  8  2 90  0  0  0
0 0 0 39316808 133008 3583132 0 0 0 240 5331 14137 12 2 86 0 0 0確認すべき重要項目は以下の4箇所です。
procs列のb(Blocked):最も重要です。 割り込み不可(I/O待ち)でブロックされているプロセス数を示します。ここが0ではなく2や5以上で張り付いている場合、ディスクI/Oが原因でロードアベレージが高騰しています。cpu列のwa(I/O Wait):CPUがディスク応答を待って何もできずにいる時間の割合です。ここが数%〜数十%ある場合、ストレージ速度がボトルネックになっています。procs列のr(Run queue):CPUの割り当てを待っているプロセス数です。CPUコア数を超える数値が続いている場合は、純粋なCPU不足です。swap列のsi/so(Swap In / Swap Out):メモリが不足してスワップ領域(ディスク)へ退避・復元が発生していないか確認します。数値が出ている場合はメモリ枯渇が原因です。
4. ロードアベレージは「過去の余韻」を引きずる
ロードアベレージは「指数加重移動平均」で計算されているため、負荷が去った後もすぐにはゼロに戻りません。
- 直近1分の平均(左端)
- 直近5分の平均(中央)
- 直近15分の平均(右端)
例えば、一瞬で数万枚のファイルをコピーして処理が10秒で終わったとしても、その瞬間の待機プロセス数が多ければ、その後数分間にわたってロードアベレージの数値には「過去の高負荷の余波」が残り続けます。
top や vmstat で以下の状態になっていれば、何も対策を打つ必要はありません。
%wa(I/O wait)が 0〜1% 前後b(ブロック中プロセス)が 0%id(アイドル率)が 80%〜90% 以上
この状態であればシステムはすでに健全であり、5〜10分待てばロードアベレージの数値も自然に1以下へ下がっていきます。
まとめ
ロードアベレージの警告が出た際は、数値の高さだけで慌てず、以下の切り分け手順を徹底しましょう。
topで%wa(I/O wait)と%id(Idle)を確認するvmstat 1 5でb(待機ブロック数)が0かどうかを見るb == 0かつ%wa == 0なら、一時的なバッチや再起動の余韻なので静観する
CPU使用率とプロセスキュー(D状態)の分離を正しく理解しておくことで、無駄なサーバースペック増強や不要なプロセス強制終了などのオペレーションミスを防ぐことができます。
コメント